Mechaine Learning
机器学习5个核心步骤
1. 获取数据
- 任务:收集待分析的原始数据,常见类型包括经验数据(比如业务日志)、图像数据、文本数据等。
- 是整个流程的“原料输入”,数据质量直接影响后续所有环节。
2. 数据基本处理
- 任务:对原始数据做“清洁”,解决数据的“脏问题”,核心操作包括:
- 缺失值处理(比如填充、删除);
- 异常值处理(比如识别并修正/剔除异常数据);
- 数据格式统一(比如日期、数值的格式标准化)。
- 目的:让数据从“原始杂乱”变成“可用的结构化数据”。
3. 特征工程
- 任务:把“数据”转化为“模型能理解的特征”,核心操作包括:
- 特征提取(比如从文本中提取词频、从图像中提取边缘特征);
- 特征预处理(比如归一化、标准化,消除量纲影响);
- 特征降维(比如用PCA减少特征数量,避免维度灾难)。
- 特征选择(选择需要的特征来训练模型)
- 特征组合(把多个的特征合并成一个特征。利用乘法或加法来完成)
- 是模型效果的“关键影响因素”(好的特征往往比模型本身更重要)。
4. 模型训练
- 任务:选择合适的算法,用处理好的特征训练模型,常见模型包括:
- 回归类:线性回归;
- 分类类:逻辑回归、决策树;
- 集成类:GBDT(梯度提升树)等。
- 是“数据→模型”的核心转化环节,需根据任务类型(回归/分类)选对应的算法。
5. 模型评估
- 任务:判断模型的效果是否达标,需根据任务类型选对应的评估指标:
- 回归任务:用MSE、R²等;
- 分类任务:用准确率、F1等;
- 聚类任务:用聚类专用指标(比如轮廓系数)。
- 若评估不达标,需要回到前面的环节(比如重新做特征工程、换模型),反复迭代调优。
有监督和无监督
- 有监督学习: 特点是“有特征+有标签”; 任务类型:标签是连续值→回归任务;标签是离散值→分类任务。
- 无监督学习: 特点是“有特征+无标签”; 核心任务:依据样本间的相似性进行分组→聚类算法(形象称为“开荒”)。
欠拟合和过拟合
- 欠拟合:
- 定义:模型学到的特征太少,无法准确预测未知样本,表现是在训练时效果就很差;
- 解决方式:可通过增加特征等方法改善。
- 过拟合:
- 定义:模型学到的特征过多,仅在训练样本表现好,但未知样本(验证集、测试集)效果差;
- 解决方式:可通过正则化、异常值检测、特征降维等方法缓解。
归一化和标准化
为什么正则化之前需要做归一化?
在使用正则化之前进行归一化,是为了让正则项对不同特征施加“公平且可比较”的约束,否则正则化的惩罚会被特征尺度主导。
归一化是将数据缩放到特定范围(常用$[0,1]$或$[-1,1]$)的预处理方法,常见计算方式有2种:
1. 最小-最大归一化(Min-Max Scaling)
公式: $X_{norm} = \frac{X - X_{min}}{X_{max} - X_{min}}$
- $X$:原始数据
- $X_{min}$:数据集中的最小值
- $X_{max}$:数据集中的最大值
- 结果范围:$[0, 1]$
- 如果要缩放到特定的范围$[m,n]$,则需要将归一化后的结果乘以组距+下组限,例如: $X=X_{norm}\times(n-m)+m$
2. 标准化(Standardization)
公式: $X_{std} = \frac{X - \mu}{\sigma}$
- $\mu$:数据的均值
- $\sigma$:数据的标准差(标准差越小,数据越集中)
- 结果范围:均值为0、标准差为1(无固定边界)
目的:核心目的是 “消除量纲”
归一化与标准化对比
| 对比维度 | 归一化(Normalization) | 标准化(Standardization) |
|---|---|---|
| 核心定义 | 将数据缩放到固定区间(默认[0,1]),消除量纲影响 | 将数据转换成均值为0,标准差为1的标准正态分布,保留数据分布特征 |
| 对异常值敏感度 | 极度敏感 | 不敏感(鲁棒) |
| 核心优势 | 1. 区间固定,结果易解释 2. 计算简单,无复杂统计量 |
1. 保留数据离散程度和异常值信息 2. 不受量纲影响,适配绝大多数模型 3. 均值0可让梯度下降收敛更快 |
| 核心缺点 | 1. 受极端值影响大($X_{max}/X_{min}$一变,结果全变) 2. 只适合数据分布已知(如近似均匀分布)的场景 |
1. 结果无固定区间,解释性弱 2. 依赖数据服从近似正态分布(不服从也能用,影响小) |
| 适用模型(重点) | 1. 依赖距离计算的模型(需固定区间):K近邻(KNN)、K-Means聚类 2. 神经网络(输入层用,加速收敛) 3. 决策树以外的距离类模型 |
1. 绝大多数机器学习模型(首选):线性回归、逻辑回归、SVM、梯度下降类模型 2. 深度学习(必用,尤其是全连接、CNN) 3. 数据分布未知、存在异常值的场景 |
| 不适用模型 | 决策树、随机森林、XGBoost等(模型不依赖距离,缩放无意义) | 同左(树模型无需归一化/标准化) |
2.1 正态分布(高斯分布/钟形分布)
- 定义:一种常见的概率分布,自然界很多数据(如身高、体重、考试成绩)符合该分布,记作 $N(\mu, \sigma)$。
- 核心参数:
- $\mu$(均值):决定分布的“位置”(曲线的中心);
- $\sigma$(标准差):决定分布的“幅度”(曲线的胖瘦)。
- 特殊形式:当 $\mu=0$、$\sigma=1$ 时,称为标准正态分布。
2.2 方差($\sigma^2$)
- 定义:衡量一组数据离散程度的统计量,是“每个数据与均值的离差平方和的均值”。
- 公式:每个 数据与均值的 差值 的平方和 的均值(标准差的平方) $\sigma^2 = \frac{1}{N}\sum_{i=1}^N (x_i-\mu)^2$ ($\mu$ 是均值,$N$ 是数据总数)
2.3标准差($\sigma$)
- 定义:方差的平方根,和原始数据的量纲一致,更直观反映数据离散程度。
- 公式:方差开平方根 $\sigma = \sqrt{\frac{1}{N}\sum_{i=1}^N (x_i-\mu)^2}$
(扩展)正态分布的“3σ法则(68-95-99.7法则)”
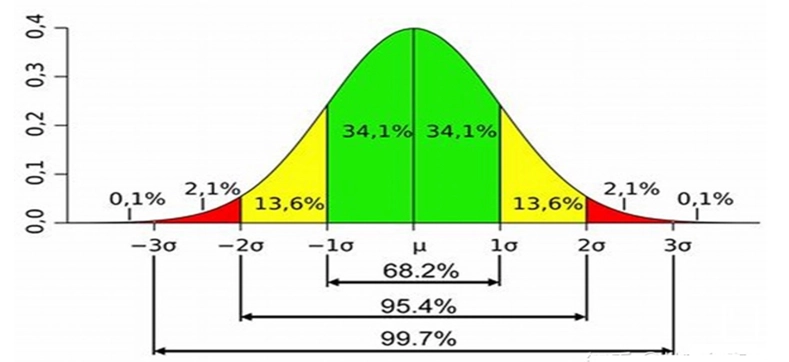
对于正态分布数据:
- $\mu \pm 1\sigma$ 区间:包含约 68.2% 的数据;
- $\mu \pm 2\sigma$ 区间:包含约 95.4% 的数据;
- $\mu \pm 3\sigma$ 区间:包含约 99.7% 的数据。
核心关联:
- 标准差 $\sigma$ 越小,正态分布曲线越“瘦高”,数据越聚集;
- 标准差 $\sigma$ 越大,曲线越“矮胖”,数据越分散。
批量归一化(Batch Normalization)
Batch Normalization 名字里叫 “Normalization”,但数学上做的是“标准化(Standardization)”。
即,对一个 batch 内,某一层所有神经元的输出值做标准化。
为什么需要 Batch Normalization?
- 因为,随着网络参数更新,中间层特征分布不断变化(起因)
- 后续层需要不停“适应新分布”
结果:
- 训练不稳定
- 学习率受限
- 收敛慢
Batch Normalization 通常放在:
线性变换(Linear / Conv)之后,非线性激活函数之前。
$\begin{aligned} z = Wx + b \ \tilde{z} = \text{BN}(z) \ h = \sigma(\tilde{z}) \end{aligned}$
有 BN 时:Linear / Conv 的 bias 通常可以去掉,即**$z = Wx$**,因为BN已经有平移能力,bias 是冗余的。
BN完整公式:
$\boxed{\text{BN}(x)=\gamma\frac{x - \mu_B}{\sqrt{\sigma_B^2 + \epsilon}}+\beta}$
其中,$\mu_B$为该batch的均值;$\sigma^2_B$为该batch的方差(开平方根后为标准差);$\epsilon$为超参数(小于$\sigma^2_B$,防止方差为0或接近0);$\gamma$和$\beta$为可学习参数,$\gamma$为尺度权重,$\beta$为偏移量
BN是对不同特征向量的相同维度计算均值标准差
LN对同一个特征向量不同的维度计算均值标准差
交叉验证和网格搜索
是一种数据集的分割方法,将训练集划分为 $n$ 份,拿一份做验证集(测试集)、其他$n-1$份做训练集
例如把数据分成4份(同样训练次数也是4):
- 第一次:把 第1份 作为验证集并记录评估指标,剩下的3份作为训练集;
- 第二次:把 第2份 作为验证集并记录评估指标,剩下的3份作为训练集;
- 第三次:把 第3份 作为验证集并记录评估指标,剩下的3份作为训练集;
- 第四次:把 第4份 作为验证集并记录评估指标,剩下的3份作为训练集;
网格搜索(Grid Search)是一种暴力枚举式的超参数调优方法,它本身可以独立使用,但在机器学习中,几乎都会和交叉验证(CV)配合 —— 核心目的是用交叉验证的 “可靠评估”,选出网格搜索中 “最优的模型参数组合”。
距离度量
1. 欧氏距离(Euclidean Distance,$p=2$)
也叫L₂距离、直线距离,是最常用的距离度量,对应二维/三维空间中两点的直线长度。 公式(代入 p=2):
$d_2(A,B)=\sqrt{\sum_{i=1}^n (a_i - b_i)^2}$
- 特点:符合人类对“距离”的直观认知,对差值敏感(平方会放大异常值影响);
- 适用场景:聚类分析(K-Means)、分类模型(KNN)、低维空间数据相似度计算。
2. 曼哈顿距离(Manhattan Distance,$p=1$)
也叫L₁距离、街区距离,是沿坐标轴方向的绝对差值之和,模拟城市街区中沿直线行走的路径。 公式(代入 p=1):
$d_1(A,B)=\sum_{i=1}^n |a_i - b_i|$
- 特点:计算简单,对异常值鲁棒性强,无平方放大效应;
- 适用场景:稀疏高维数据、网格路径规划、推荐系统等。
3. 闵氏距离(Minkowski Distance)
是一组距离的通用表达式,定义了n维空间中两个点 $A=(a_1,a_2,...,a_n)$ 和 $B=(b_1,b_2,...,b_n)$ 之间的距离。 公式:
$d_p(A,B)=\sqrt[p]{\sum_{i=1}^n |a_i - b_i|^p}$
其中 p 是距离阶数,为非负实数,不同的 p 对应不同的具体距离。
4. 切比雪夫距离(Chebyshev Distance,$p\to\infty$)
也叫L∞距离、棋盘距离,是各维度差值绝对值的最大值,模拟国际象棋中王的移动方式(可以横向、纵向、斜向走任意步数)。 公式(p 趋近于无穷大时推导):
$d_\infty(A,B)=\max_{1\le i\le n} |a_i - b_i|$
- 特点:关注差异最大的维度,忽略其他维度的小差异;
- 适用场景:多维度条件下的极值优化、棋盘类路径规划、工业质检(关注最大偏差)。
损失函数
损失函数用来衡量真实值和预测值之间的差异
$误差=预测值-真实值$
因此,损失函数是一个对所有样本误差的函数,损失函数是关于模型参数$\theta$的函数,用于计算模型参数$\theta$。
均方误差(Mean-Square Error, MSE)
$MSE = \frac{最小二乘}{n}=\frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2$
- $n$:样本总数
- $y_i$:第i个样本的真实值(比如真实房价)
- $\hat{y}_i$:第i个样本的预测值(模型算出来的房价)
- 计算逻辑:先算每个样本的误差平方 → 求和 → 取平均,其中误差平方 → 求和为最小二乘法
为什么要平方?
答:为了抵消正负数求和无法比较差异的问题,例如$-2+2=0$;为了放大误差;为了容易求导,使函数变光滑,如果再开根号则会增加求导难度。
为什么要平均?
答:让损失值与样本数无关。
均方根误差(Root Mean Squared Error, RMSE)- MSE的直观解读版
-
核心公式:$RMSE = \sqrt{MSE} = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}$
为什么要开根号?
答:因为有平方,开根是为了还原为原始量纲
-
核心特点
- 本质:是MSE的开根,优化目标和MSE完全一致,只是结果还原为原始量纲;
- 优点:继承MSE的凸性和可导性,同时解读直观(如房价预测RMSE=3万,直接反映平均误差);
- 缺点:仍对异常值敏感(和MSE一致)。
-
适用场景:MSE优化后,用于业务汇报、结果解读,不单独作为损失函数训练模型。
平均绝对误差 (Mean Absolute Error , MAE)
$MAE = \frac{1}{n}\sum_{i=1}^{n}|y_i - \hat{y}_i|$
- $n$:样本总数
- $y_i$:第i个样本的真实值(比如真实房价、真实温度)
- $\hat{y}_i$:第i个样本的预测值(模型输出的结果)
- $|\cdot|$:绝对值符号(核心作用是抵消正负误差,避免相互抵消)
- 计算逻辑:先算每个样本的绝对误差 → 求和 → 取平均
交叉熵损失
在二分类中:$y_i \in {0,1}$。因此,$y_i$ 是一个 伯努利随机变量(Bernoulli)。
伯努利分布定义,如果:$Y \sim \text{Bernoulli}(p)$
那么它的概率是:
$P(Y=y) = \begin{cases} p, & y=1 \ 1-p, & y=0 \end{cases}$
用一个「统一公式」写这两种情况
数学上常写成:
$\boxed{P(Y=y)=p^y(1-p)^{1-y}}$
- 若 $(y=1)$:$p^1(1-p)^0 = p$
- 若 $(y=0)$:$p^0(1-p)^1 = 1-p$
最后,把“每个样本的伯努利概率”乘起来:
$\boxed{P=\prod_{i=1}^np_i^{y_i}(1-p_i)^{1-y_i}}$
接下来:
-
取对数
$\log P = \sum_{i=1}^n \Big[ y_i\log p_i + (1-y_i)\log(1-p_i) \Big]$
-
加负号
-
得到交叉熵损失
$\boxed{\mathcal{L}=-\sum_{i=1}^n\Big[y_i\log p_i+(1-y_i)\log(1-p_i)\Big]}$
!TODO: 多分类交叉熵损失
单标签多分类用CE交叉熵(自带softmax),多标签多分类用BCE交叉熵(自带sigmoid)
梯度(Gradient)
梯度是损失函数求导得来的
单变量函数$J(\theta)$:$\text{梯度} = J'(\theta) = \frac{dJ(\theta)}{d\theta}$
多变量函数$J(\theta_1,\theta_2,...,\theta_n)$:$\text{梯度}=\nabla J(\theta_1,\theta_2,...,\theta_n) = \left( \frac{\partial J}{\partial \theta_1},\ \frac{\partial J}{\partial \theta_2},\ ...,\ \frac{\partial J}{\partial \theta_n} \right)$
- $J(\cdot)$为损失函数
- $\theta$为参数
机器学习中,我们训练模型,本质目标是:让模型的预测结果,尽可能接近真实标签。
为了衡量“误差”,我们引入损失函数$J(\theta)$,而损失函数的图像就像一个连绵起伏的山丘,找到损失函数的最小值这个目标就是要找到这个山丘的最低点(学习到最优参数)。
而求这个最低点有两种方法:1. 用解析解(正规方程,只适用于极少数情况);2. 梯度下降法。
例如求多元线性回归解析解(正规方程法)的步骤:
- 展开损失函数,对参数求偏导
- 设导函数为0
- 求参数值
| 对比维度 | 正规方程 | 梯度下降 |
|---|---|---|
| 求解方式 | 解析解,直接计算 | 数值迭代,逐步逼近 |
| 是否找全局最优 | 是,直接得到全局最优 | 是,凸函数下迭代收敛到全局最优 |
| 是否需要调参 | 无需调参 | 必须调学习率$\alpha$,需设迭代次数 |
| 计算复杂度 | $O(n^3)$,$n$为特征数 | $O(mnk)$,$m$样本数,$n$特征数,$k$迭代次数 |
| 样本 / 特征适用性 | 小特征数 $(n\leq10000)$友好 | 大样本、大特征数友好 |
| 是否需要归一化 / 标准化 | 不需要,直接计算 | 需要,否则收敛慢 |
| 是否受逆矩阵影响 | 要求$X^TX$可逆,不可逆需正则化 | 无此限制 |
因此,实际中常用梯度下降法(数值解)优化来找到最优参数。
梯度如何下降?
参数更新公式(梯度下降公式):$\theta_{i+1}=\theta_i-\alpha\frac{\partial}{\partial\theta_i}J(\theta)$,
或者说:$新参数=旧参数-学习率×梯度$
梯度下降是一种迭代式优化方法,用于最小化损失函数
梯度下降的优化流程
- 初始化参数 $\theta$ 和学习率 $\alpha$
- 计算当前点的梯度
- 沿 负梯度 方向更新参数
- 重复迭代直至收敛
- 相邻两次损失变化小于阈值
- 或达到最大迭代次数
为什么梯度前要加负号
- 梯度指向的是函数值上升最快的方向
- 训练目标是最小化损失函数
- 因此需要沿负梯度方向更新参数,实现最快下降
学习率(Learning Rate)的作用与影响
定义:学习率决定了每一步沿负梯度方向前进的长度
影响分析:
- 学习率过小
- 收敛稳定但速度慢
- 学习率过大
- 容易越过最优点
- 产生震荡甚至发散(梯度爆炸)
梯度下降法
1. 全梯度下降(FGD)
- 逻辑:每次迭代用全部样本的梯度值计算更新
- 公式:$\theta_{i+1} = \theta_i - \alpha \sum_{j=0}^m (h_\theta(x_0^{(j)},…,x_n^{(j)}) - y_j)x_i^{(j)}$($m$为总样本数)
2. 随机梯度下降(SGD)
- 逻辑:每次迭代随机选1个样本的梯度值计算更新
- 公式:$\theta_{i+1} = \theta_i - \alpha (h_\theta(x_0^{(j)},…,x_n^{(j)}) - y_j)x_i^{(j)}$
- 代码示例:
from sklearn.linear_model import SGDRegressor
3. 小批量梯度下降(mini-batch)(最常用)
- 逻辑:每次迭代随机选小批量样本($1<x<m$)的梯度值计算更新
- 公式:$\theta_{i+1} = \theta_i - \alpha \sum_{j=t}^{t+x-1} (h_\theta(x_0^{(j)},…,x_n^{(j)}) - y_j)x_i^{(j)}$
- 特殊情况:$\text{batch_size}=1$时等价于SGD;$batch_size=m$时等价于FGD
4. 随机平均梯度下降(SAG)
- 逻辑:每次迭代随机选1个样本,结合“历史样本梯度的均值”更新(会存储并更新历史梯度)
- 步骤:
- 选样本计算梯度并存储,用列表均值更新参数;
- 重复选样本,存储/更新历史梯度,再用均值更新;
- 直到收敛。
梯度下降优化方法
“梯度下降优化算法”本质上都是在回答同一个问题:如何利用梯度信息,更快、更稳定地更新参数。
当前梯度$g_t = \nabla_\theta L(\theta_t)$
原始梯度下降($W_新=W_旧\times\eta g_t$)1. 容易陷入鞍点(拐点处导数为0);2. 缺乏加速机制导致遇到缓坡梯度下降慢;3. 陷入局部最小值区域,容易在局部最小值附近左右震荡;4. 遇到悬崖由于梯度过大容易跳过悬崖
动量法(Momentum)
以往的梯度下降法(如SGD)仅仅依赖负梯度,而Momentum考虑到了历史的梯度来计算本次权重更新的方向(替代了权重更新的“梯度”),这样就相当于是负梯度与历史梯度的折中方向。
更新步骤:
- 更新动量:$v_t = \beta v_{t-1} + (1-\beta) g_t$,$\beta$常取 0.9。公式表示历史梯度的指数加权平均。
- 参数更新:$\theta_{t+1} = \theta_t - \eta v_t$
缺陷:仍然会带着历史动量跳过悬崖或者在悬崖内反复横跳,损失曲面地形突变时,旧惯性拖后腿
AdaGrad
为每个参数自适应调整学习率,学习率更新方式为学习率除以历史梯度和的平方根(类似欧氏距离,L2范数)。当梯度很大时,学习率除以梯度后就会被调整得很小,这样就避免了跳过悬崖的现象。
更新步骤:
- 累计梯度平方:$G_t = G_{t-1} + g_t^2$,展开为$g_{1}^2+g_{2}^2+g_{3}^2+\cdots+g_{n}^2$
- 参数更新: $\theta_{t+1} = \theta_t- \frac{\eta}{\sqrt{G_t} + \epsilon} \cdot g_t$,为了数值稳定性引入很小常数$\epsilon$,$\epsilon \approx 10^{-8}$
缺陷:由于是累计梯度,因此学习率会持续衰减,因此梯度到后面就下降不动了,导致欠拟合。
RMSProp
之前的AdaGrad是对梯度全量累加(永久记忆)
RMSProp是对 AdaGrad 的优化。最主要的不同是,其使用指数加权平均梯度替换历史梯度的平方和。
更新步骤:
- 计算$s_t$以调整学习率,计算采用指数加权平均梯度(只记最近) $s_t = \beta s_{t-1} + (1-\beta) g_t^2$ 不再无脑累加,旧梯度慢慢忘掉
- 参数更新 $\theta_{t+1} = \theta_t - \frac{\eta}{\sqrt{s_t}+\varepsilon},g_t$
缺点:它只看梯度大小来刹车,但不管梯度方向,仍然容易在局部最优附近过冲、震荡。
Adam
Adam优化算法(Adaptive Moment Estimation,自适应矩估计)将 Momentum 和 RMSProp 算法结合在一起
- 修正梯度: 使⽤梯度的指数加权平均
- 修正学习率: 使⽤梯度平⽅的指数加权平均
计算步骤:
0)如果带权重衰减(weight_decay)它会 先把 L2 揉进梯度: $\tilde g_t = g_t + \color{yellow}{\lambda \theta_t}$
1)一阶(Momentum,调整梯度) $m_t = \beta_1 m_{t-1} + (1-\beta_1) g_t$
2)二阶(RMSProp,调整学习率) $v_t = \beta_2 v_{t-1} + (1-\beta_2) g_t^2$
3)校正 $\hat m_t,\ \hat v_t$
4)基础更新 $\theta_{t+1} = \theta_t - \eta \frac{\hat m_t}{\sqrt{\hat v_t}+\varepsilon}$
AdamW
第一步:照常跑 Adam(只用真实损失梯度,不带 L2)
$m_t,v_t,\hat m_t,\hat v_t$ $\theta_{\rm tmp} = \theta_t - \eta \frac{\hat m_t}{\sqrt{\hat v_t}+\varepsilon}$
第二步:更新完,外面单独补一次纯正权重衰减
$\theta_{t+1} = \theta_{\rm tmp} - \color{yellow}{\eta \lambda \theta_t}$
就多这一行。
Adam和AdamW的区别
① 原始 Adam 的问题
- (引用)梯度会被学习率、动量、自适应学习率多次缩放
- 导致权重衰减失效,模型容易过拟合、正则化效果不稳定
② AdamW 的改进
- 把权重衰减独立于梯度更新单独计算
- 正则化效果稳定、可控,不会被优化器参数干扰
- 有效防止过拟合,模型泛化能力更强
梯度消失和梯度爆炸
梯度的计算本质是链式求导
神经网络训练依赖反向传播:从输出层计算损失函数的梯度,逐层传递到输入层,更新每层权重(参数更新公式:$W = W - \eta \cdot \nabla W$,$\nabla W$ 为梯度,是损失函数对参数求偏导得来的)
假设:
- 输入 $x \in \mathbb{R}^{n}$
- 第一层权重 $W_1$,输出 $h_1 = \sigma_1(z_1) = \sigma_1(W_1 x)$
- 第二层权重 $W_2$,输出 $h_2 = \sigma_2(z_2) = \sigma_2(W_2 h_1)$
- 第三层(输出层)权重 $W_3$,输出 $y_{\text{pred}} = \sigma_3(z_3) = \sigma_3(W_3 h_2)$
损失函数为 $L(y_{\text{pred}}, y)$,$\sigma$为激活函数。
从输出层到输入层的反向传播计算过程为:
$\begin{aligned}
\nabla_{W_3} L = \frac{\partial L}{\partial y_{\text{pred}}} \odot \sigma_3'(z_3) h_2^\top
\end{aligned}$
$\nabla_{W_2} L = \big(W_3^\top (\frac{\partial L}{\partial y_{\text{pred}}} \odot \sigma_3'(z_3)) \odot \sigma_2'(z_2) \big) h_1^\top$
最终为:$\nabla_{W_1} L = \big(W_2^\top (W_3^\top (\frac{\partial L}{\partial y_{\text{pred}}} \odot \sigma_3'(z_3)) \odot \sigma_2'(z_2)) \odot \sigma_1'(z_1) \big) x^\top$
梯度消失和梯度爆炸的原因
因此,梯度的大小和稳定性由网络结构(层数、每层神经元个数)、激活函数($\sigma$)、权重初始化($W$)、输入数据分布($x$)、优化器参数以及正则化策略共同决定。
- 梯度消失(Vanishing Gradient)
- 如果每层系数($|W \cdot \sigma'(z)| < 1$)
- 多层相乘后 → 梯度指数级衰减 → 趋近 $0$
- 梯度爆炸(Exploding Gradient)
- 如果每层系数($|W \cdot \sigma'(z)| > 1$)
- 多层相乘后 → 梯度指数级放大 → 趋近无穷大
这就是为什么深层网络训练困难,尤其是 RNN 或很深的前馈网络。深层网络训练的核心就是保证梯度既不过小也不过大,才能有效更新权重。
大多数情况下梯度不稳定主要由以下三个因素造成:
- 权重初始化不合适
- 激活函数选择或输入分布导致梯度消失/爆炸
- 学习率过大或梯度本身放大(深层网络/长序列)
| 优化类别 | 对应方法 | 核心原因(为什么归为此类) |
|---|---|---|
| 针对激活函数优化 | 1. 更换非饱和激活函数 | 直接替换激活函数本身,通过改变激活函数的导数特性,避免梯度被过度缩小(如用ReLU的导数=1替代Sigmoid导数≤0.25),核心优化对象是激活函数 |
| 针对权重优化 | 1. 权重初始化 5. 梯度裁剪 |
1. 权重初始化:直接约束权重的初始值分布,让权重矩阵的谱范数接近1,避免梯度连乘时过度缩放; 2. 梯度裁剪:直接限制权重梯度的最大范数,防止梯度爆炸导致权重更新失控; |
| 同时优化权重+激活函数 | 2. 批量归一化(BN) 4. 残差连接 6. 优化网络架构 |
1. BN: - 对权重:稳定权重的梯度传递,让权重的谱范数乘积接近1; - 对激活函数:将激活函数的输入拉回均值0、方差1的分布,避免激活函数进入饱和区(如Sigmoid的两端),提升导数有效性; 2. 残差连接: - 对权重:提供梯度“短路通道”,避免梯度在权重多层连乘中消失; - 对激活函数:让激活函数的输入更稳定,减少因输入分布漂移导致的导数失效; 3. 优化网络架构(Transformer/LSTM替代RNN): - 对权重:用自注意力/门控机制替代权重的时间步连乘,避免梯度缩放; - 对激活函数:搭配非饱和激活函数(如GELU/ReLU),进一步提升梯度稳定性 |
核心总结
- 针对激活函数:只改激活函数的“特性”,解决导数过小导致的梯度消失;
- 针对权重:直接改权重的“初始值”或“梯度上限”,解决权重连乘导致的梯度缩放;
- 同时优化:通过改变网络结构或数据分布,同时改善权重的梯度传递和激活函数的工作状态,是深层网络稳定训练的核心组合方案(如 BN+残差连接+ReLU 是现代网络的标配)。
激活函数
如果没有激活函数,多层神经网络只是 “加权求和” 的线性叠加,无论堆叠多少层,整个网络依然是线性模型,无法拟合复杂的非线性模式。
激活函数正是通过对加权求和的结果(预激活值 $z=Wx+b$)进行非线性变换,最终让整个网络的映射关系变成非线性函数,从而精准拟合样本的不同特征(包括线性和非线性特征)。但激活函数还承担了其他关键功能,比如:控制输出范围(sigmoid/tanh等)、缓解梯度消失(RELU等)、“隐式”正则化(RELU等)。
常用的激活函数
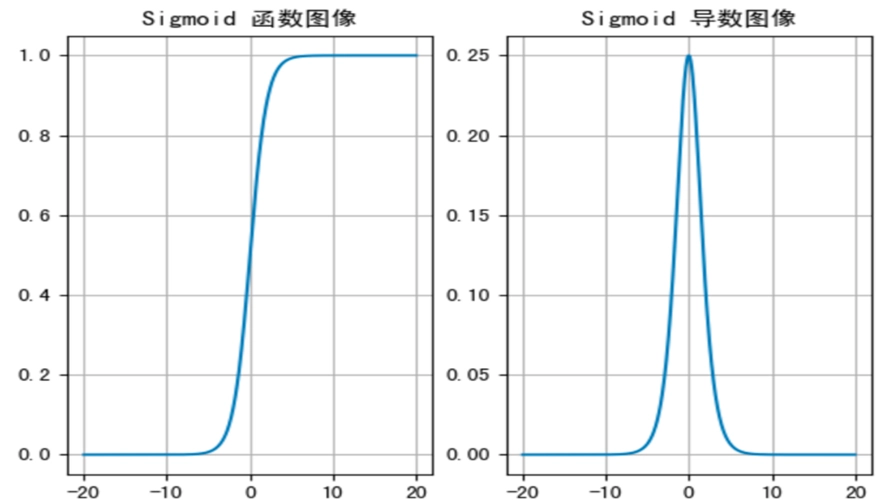
- Sigmoid函数
- 公式:$\sigma(x) = \frac{1}{1+e^{-x}}$
- 特点:输出范围$(0,1)$,可表示概率;
- 输入值在 [-6, 6] 之间输出值才会有明显差异,输入值在 [-3, 3] 之间才会有比较好的效果
- 但存在梯度消失问题。导数数值范围是 (0, 0.25),$x$绝对值较大时(输入 <-6 或者 >6 时)梯度接近$0$,导致参数无法更新。因此sigmoid函数层数要尽量少,防止(0.25*0.25……)
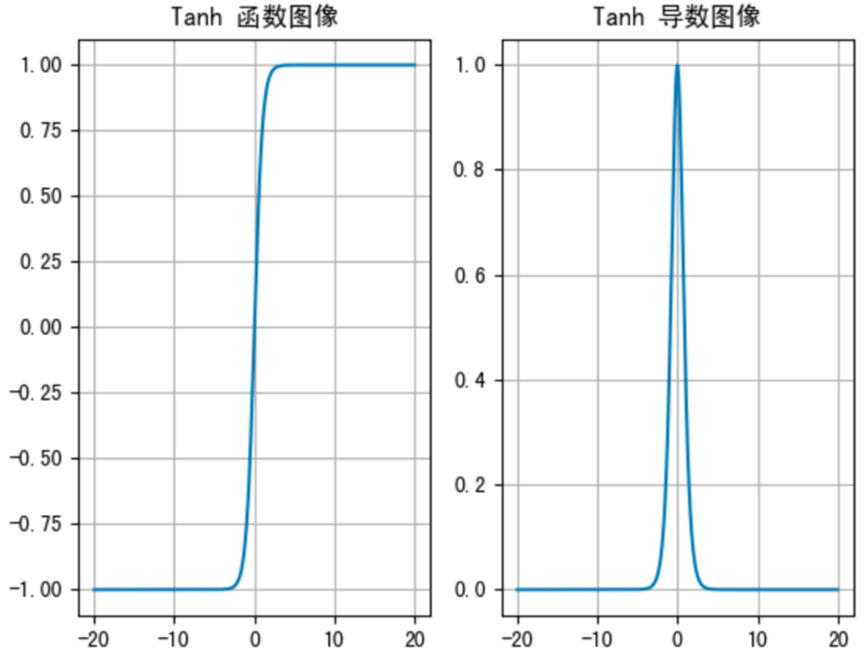
- Tanh函数
- 公式:$\tanh(x) = \frac{e^x - e^{-x}}{e^x + e^{-x}}$
- 特点:输出范围$(-1,1)$,零均值;仍存在梯度消失问题,计算复杂度略高于$\text{Sigmoid}$。
- 其导数值范围 (0, 1),当输入的值大概 <-3 或者 > 3 时,其导数近似 0。
-
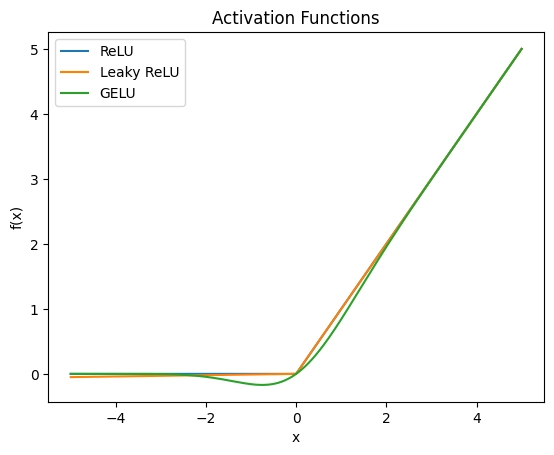
ReLU函数(Rectified Linear Unit)
- 公式:$\text{ReLU}(x) = \max(0, x)$
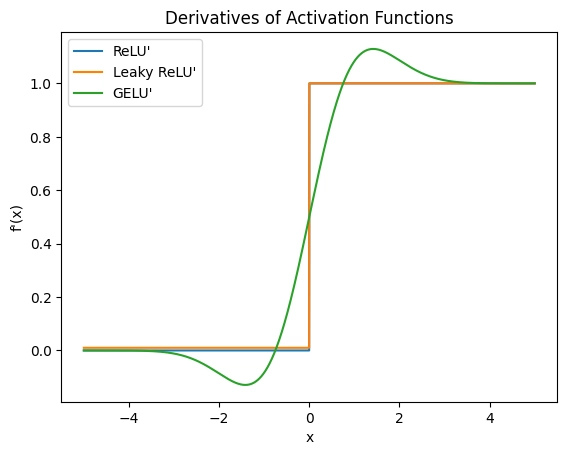
- 特点:计算简单、缓解梯度消失;但存在“神经元死亡”问题($x<0$时梯度为$0$,导致参数无法更新)。
- Leaky ReLU函数
- 公式:$\text{Leaky ReLU}(x) = \max(\alpha x, x)$($\alpha$为小常数,通常取$0.01$)
- 特点:解决$\text{ReLU}$的“神经元死亡”问题(负数区域不再是 0);但$\alpha$为人工设定,缺乏自适应调整。
- GELU函数(Gaussian Error Linear Units)
- 公式:$\text{GELU}(x) = x \cdot \Phi(x)$($\Phi(x)$是标准正态分布的累积分布函数)
- 特点:平滑的非线性激活(激活函数越平滑,越容易拟合自然数据);广泛用于Transformer架构,计算复杂度略高。
-
Softmax函数
- 公式:$\text{Softmax}(x_i) = \frac{e^{x_i}}{\sum_{j} e^{x_j}}$
- 特点:输出为$(0,1)$的概率分布,和为$1$;常用于多分类任务的输出层,但对输入敏感(易受极端值影响)。
- 为什么 softmax 的“导数趋近 0”特别危险?softmax 输出的概率分布要避免接近0、1。因为softmax 几乎总是在输出层,而且所有梯度必须经过它,它就像反向传播的“总闸门”,而它的偏导为:$\frac{\partial y_i}{\partial x_j} = y_i(\delta_{ij} - y_j)$,其中$y_i=\frac{e^{x_i}}{\sum_{j} e^{x_j}}$,当 $y_i \approx 1$ 或 $0$ 时:$\frac{\partial y}{\partial x} \approx 0$
对于隐藏层:
- 优先选择$\text{ReLU}$激活函数
- 如果$\text{ReLU}$效果不好,那么尝试其他激活,如$\text{Leaky ReLu}$等。
- 如果你使用了$\text{ReLU}$, 需要注意一下
死亡$\text{ReLU}$问题, 避免出现$0$梯度($x<0$时梯度为$0$)从而导致过多的神经元死亡。 - 少用$\text{Sigmoid}$激活函数,可以尝试使用$\text{tanh}$激活函数
对于输出层:
- 二分类问题选择$\text{Sigmoid}$激活函数
- 多分类问题选择$\text{Softmax}$激活函数
- 回归问题选择$\text{identity}$激活函数
激活函数的权重初始化
方差如何影响激活?
- 方差可以反应每一层神经元对样本的区分能力,如果方差等于0,则任意样本都被当成一样的
- 方差过大表示神经元的输入z 的绝对值非常大,那么激活输出几乎全是 ±1 或 0/1 ⇒导数几乎全是 0
只要方差约等于$\frac{1}{n}$信号就能稳定传播,但是激活函数改变了“信号分布”。这直接影响下一层输入的:均值、方差、是否对称。
初始化不是为了“随机”,而是为了补偿激活函数对信号与梯度分布造成的偏移。
1. 常数初始化
- 全零初始化(Zero Initialization):
nn.init.zeros_(),最常用的偏置项初始化方式(偏置项一般无需复杂初始化); - 全 1 初始化(One Initialization):
nn.init.ones_(),极少用于权重(易导致梯度爆炸),仅偶尔用于特殊场景; - 自定义常数初始化:
nn.init.constant_(),可指定任意固定值。
优先用于偏置项(bias)(几乎所有模型的偏置项都可初始化为 0);
不适合用于权重项(weight)(多层网络中权重全零会导致「神经元对称性问题」,所有神经元学习到相同特征,无法形成差异化表达)。
2. 自适应激活函数的优化初始化
- Xavier(泽维尔)初始化
- Xavier 均匀分布(Xavier Uniform):
nn.init.xavier_uniform_(),默认从区间$[-\sqrt{\frac{6}{\text{in_dim}+\text{out_dim}}}, \sqrt{\frac{6}{\text{in_dim}+\text{out_dim}}}]$采样(in_dim输入神经元(特征)数,out_dim输出神经元数); - Xavier 正态分布(Xavier Normal):
nn.init.xavier_normal_(),从均值为 $0$、标准差为 $\sqrt{\frac{2}{\text{in_dim}+\text{out_dim}}}$ 的正态分布采样。
- Xavier 均匀分布(Xavier Uniform):
- He/Kaiming 初始化
- 针对
ReLU及其变体(Leaky ReLU、ReLU6、PReLU)优化,由于 ReLU 会将负半部分置零,方差损失约一半,所以它为解决 Xavier 初始化在 ReLU 下的梯度消失问题 - He 均匀分布(He Uniform):
nn.init.kaiming_uniform_(),默认从区间$[-\sqrt{\frac{6}{\text{in_dim}}}, \sqrt{\frac{6}{\text{in_dim}}}]$采样(仅考虑输入特征数in_dim); - He 正态分布(He Normal):
nn.init.kaiming_normal_(),从均值为 0、标准差为 $\sqrt{\frac{2}{\text{in_dim}}}$ 的正态分布采样。
- 针对
| 激活 | 激活前参数初始化方法 |
|---|---|
| Sigmoid / Tanh | Xavier |
| ReLU / Leaky ReLU | kaiming(He) |
浅层网络:随机初始化即可
深层网络:需要考虑方差平衡,如 Xavier 或 kaiming 初始化
正则化
模型训练的优化目标是:$\min_w \mathcal{L}(w)$,表示以模型参数$w$为优化变量,找到一个使损失函数(目标函数/代价函数)值最小的点。
正则化的操作就是在原始损失函数上叠加一个正则项,目的是惩罚过于复杂的模型,防止过拟合。
加入正则化项后:$\boxed{\min_w \mathcal{L}(w) + \lambda \Omega(w)}$
其中,$\Omega(w)$为正则项,衡量模型复杂度(通常是参数 $w$ 的函数),$\lambda$为正则化系数,控制正则项的权重。($λ$ 越大,对复杂模型的惩罚越重)
L1 正则倾向于产生稀疏解(权重为 0),而 L2 正则倾向于让权重整体变小但不为 0。
L1 正则(Lasso)
数学定义:$\Omega(w) = \sum_i |w_i|$
- 惩罚的是 参数的绝对值(对大权重和小权重一视同仁)
- 很容易把参数直接“推到 0”(起到特征选择的作用)
解析:
当$w > 0$时,$\frac{d}{dw}|w| = \frac{d}{dw}w = 1$
当$w < 0$时,$\frac{d}{dw}|w| = \frac{d}{dw}(-w) = -1$
当$w = 0$时,根据导数定义求解得到右导数 = 1,左导数 = -1,因此不可导
那么根据参数更新公式:$新参数=旧参数-学习率×梯度$
可以看出,梯度的符号会受$\frac{d}{dw}|w|$的影响,当$w > 0$梯度为正,$w < 0$梯度为负,那么:
$w > 0$:$w^*=+w-\eta\times(\cdots+w)$,越减越多,就会被推向$0$
$w<0$:$w^*=-w-\eta\times(\cdots-w)=-w+\eta w$,越加越多,就会被推向$0$
L2 正则(Ridge / Weight Decay)
数学定义:$\Omega(w) = \sum_i w_i^2$
- 惩罚的是 权重的平方(大权重惩罚更重,小权重惩罚更轻)
- 不会轻易变成 0(从而提升模型的泛化能力)
解析:
为看清方向,我们把L2正则项定义为:$\Omega(w) = \frac{1}{2} w^2$
梯度计算结果:$\frac{d}{dw}(\frac{1}{2}w^2)= w$
梯度更新公式变形:$w_{\text{new}} = (1 - \eta\lambda) w$
无论$w$为正或为负,$w_{\text{new}}$都会逐渐接近$0$,但随着$w$的逐渐变小,变化幅度也会越来越小(只要$0<\eta\lambda<1$)
**总结:**由于 L1 正则项的梯度在$w$不为 0 时为常数 ±1,因此即使$w$已经很小,仍会受到恒定的收缩作用,从而可能在有限步内被推到 0;而 L2 正则项的梯度与$w$大小成正比,在$w$趋近 0 时梯度也趋近 0,收缩作用逐渐消失,因此$w$只能无限接近 0 而不会精确变为 0。
| 对比维度 | L1 正则 | L2 正则 |
|---|---|---|
| 惩罚形式 | $ | w |
| 解的稀疏性 | 强 | 弱 |
| 是否自动特征选择 | 是 | 否 |
| 梯度行为 | 常数级 | 与权重成正比 |
| 优化稳定性 | 较差 | 很好 |
| 深度学习中常用 | 少 | 非常常用 |
Dropout正则化
神经网络强大的表示能力经常遇到过拟合,所以需要使用不同形式的正则化策略,常用的手段有范数惩罚,DropOut,特殊的网络层等。
Dropout 在训练时,随机“关闭”一部分神经元,使网络不能依赖某些固定的特征组合。
为什么 Dropout 要放在激活之后?
每个神经元学习的是一个特征,Dropout 关闭特征才有意义,而不是线性变换本身。放在激活函数之前,会破坏子网络假设、梯度统计和训练—推理一致性,因此不推荐。
但是Dropout**原则上应当放在非饱和激活函数之后;**饱和的激活函数会让大量的激活函数输出值趋近于某个固定常数(如 0、1、±1),从而削弱 Dropout 的作用。
在神经网络里,“饱和 / 非饱和”是形容导数行为。
饱和(Saturation):在“高概率输入区间”内,激活函数的一阶导数接近 0,且对输入变化不敏感。
非饱和(Non-saturation):在“高概率输入区间”内,导数值保持在一个不接近 0 的范围。
什么是激活函数的“高概率输入区”?这是由参数初始化决定的,
- sigmoid:当$∣x∣>6$,导数值几乎为 0 → 导致参数无法更新、损失无法下降
- Tanh:当$∣x∣>3$,导数值几乎为 0
- RELU:半饱和,正半轴:导数 = 1(非饱和)负半轴:导数 = 0(饱和)
- Leaky ReLU、ELU、GELU是非饱和的
混淆矩阵
| 真实\预测 | 正例(P) | 负例(N) |
|---|---|---|
| 正例(P) | $\text{T P}$(True Positive)真实正例 → 预测正例 | $\text{F N}$(False Negative)真实正例 → 预测负例 |
| 负例(N) | $\text{F P}$(False Positive)真实负例 → 预测正例 | $\text{T N}$(True Negative)真实负例 → 预测负例 |
准确率(Accuracy)
预测正确的样本数(正 + 负)占总样本数的比例
$\text{ACC} = \frac{TP + TN}{TP + TN + FP + FN}$
精确率(Precision,查准率)
所有“被模型预测为正类”的样本中,有多少是真的正类
$\text{Precision} = \frac{TP}{TP + FP}$
召回率(Recall,查全率)
正样本中预测正确了多少个
$\text{Recall} = \frac{TP}{TP + FN}$
F1 分数
F1是精确率和召回率的综合评估,F1 只有在 Precision 和 Recall 都高时才会高
$\text{F1} = \frac{2 \cdot \text{Precision} \cdot \text{Recall}}{\text{Precision} + \text{Recall}}$
ROC 曲线
评估二分类模型在 “不同分类阈值下” 的性能权衡,直观展示 “漏诊率 vs 误诊率” 的权衡
-
X 轴:假正率(FPR)
负样本中,被错误预测为正样本的比例
$\text{FPR} = \frac{FP}{FP + TN}$
-
Y 轴:真正率(TPR)
正样本中,被正确预测为正样本的比例
$\text{TPR} = \frac{TP}{TP + FN}$
什么是Temperature(温度参数T)?
“温度参数(temperature)”是一个控制输出分布“平滑程度”或“随机性”的超参数。
✅ 通俗解释一句话:
Temperature 控制模型生成时的“随机性”或“创造性”。
温度越高,模型越“大胆”;温度越低,模型越“保守”。
🔢 数学解释:
假设一个模型对下一个词的预测是一个 softmax 概率分布:
$P(x_i) = \frac{\exp(z_i / T)}{\sum_j \exp(z_j / T)}$
- $z_i$:表示每个词的原始得分(logits)
- $T$:就是 temperature(温度)
通过除以温度 $T$,你可以改变概率分布的“尖锐”程度:
| 温度 $T$ | 作用 | 生成效果 |
|---|---|---|
| $T = 1$ | 标准 softmax | 正常输出 |
| $T < 1$ | 放大差距 → 更确定 | 输出更保守、常见、确定性强 |
| $T > 1$ | 压缩差距 → 更平滑 | 输出更多样、随机、有创意 |
| $T \to \infty$ | 所有概率趋近相等 | 接近完全随机选择 |
🎯 举个例子(GPT 生成):
假设某一步的词候选分布是(未归一化):
logits: [cat: 5.0, dog: 4.9, banana: 2.0, unicorn: 1.5]
- T = 0.7(保守) → 更可能选出 cat / dog
- T = 1.0(标准) → 大概率选 cat,偶尔有 banana
- T = 1.5(发散) → unicorn 出现几率上升
- T → 0 → 几乎总是选最高分(cat)
- T → ∞ → 四个几乎等概率选
📦 在知识蒸馏中,temperature 用于:
- 让 teacher 模型的 softmax 输出更加“软”(平滑),让 student 模型学习更丰富的知识(不仅是对错标签,而是分布趋势)
🎨 应用场景对比:
| 场景 | 推荐温度 | 原因 |
|---|---|---|
| 新闻摘要、问答 | 0.5~0.7 | 需要可靠、稳定,不能乱说话 |
| 诗歌、故事、创意文案 | 0.9~1.3 | 需要多样、意外、富有创意 |
| 代码生成 / 数据分析 | 0.2~0.5 | 更保守、避免出错 |
| 对话系统 | 0.7~1.0 | 兼顾稳定与人类化 |
🧠 和 Top-k / Top-p 的区别?
| 方法 | 控制原理 | 特点 |
|---|---|---|
| Temperature | 调整 softmax 分布形状 | 连续控制,越大越多样 |
| Top-k | 限制只在前 k 个高概率词中选 | 限制候选词数量 |
| Top-p (nucleus sampling) | 累加到某个概率阈值 p 的词中选 | 更智能的多样性控制 |
通常这些方法可以组合使用。
什么是Top-k sampling和 Top-p sampling?
Top-k 和 Top-p(又称 nucleus sampling) 是两种控制语言模型生成“多样性与合理性”的采样策略,它们决定了从哪个候选词集合中采样下一个词。
它们都是为了解决温度调节不能有效控制生成质量与多样性之间权衡的问题。
🧮 一、Top-k sampling(前 k 采样)
只从概率最高的前 k 个词中进行随机选择,其余全丢掉。
举例:
假设模型当前的下一个词预测概率分布如下(排序后):
| Token | Prob |
|---|---|
| "the" | 0.35 |
| "a" | 0.20 |
| "an" | 0.10 |
| "this" | 0.05 |
| "dog" | 0.03 |
| ... | ... |
如果 top_k = 3,那么只从 "the", "a", "an" 这三个里采样,其余忽略。
🧮 二、Top-p sampling(nucleus sampling)
从最有可能的词开始累计概率,直到总和 ≥ p(如 0.9),然后只从这部分中采样。
它不像 top-k 固定数量,而是动态选择一个“够高概率”的子集。
举例:
| Token | Prob | 累计概率 |
|---|---|---|
| "the" | 0.35 | 0.35 |
| "a" | 0.20 | 0.55 |
| "an" | 0.10 | 0.65 |
| "this" | 0.05 | 0.70 |
| "dog" | 0.03 | 0.73 |
| "is" | 0.025 | 0.755 |
| ... | ... | ... |
如果 top_p = 0.75,则取前 6 个 token 构成候选集,从中采样。
🔍 对比总结:
| 特征 | Top-k | Top-p |
|---|---|---|
| 固定词数 | ✅ 是 | ❌ 否(动态) |
| 高概率词优先 | ✅ 是 | ✅ 是 |
| 控制采样“保守性” | ✅ 但粗糙 | ✅ 更细腻 |
| 易实现 | ✅ | 稍复杂 |
| 更灵活 | ❌ | ✅ |
🧠 温度 + Top-k / Top-p 联合使用?
常见做法:
temperature=1.0(或略高)+top_p=0.9- 或者
temperature=0.7+top_k=50 - 有时使用 temperature 调节分布平滑性,再用 top-p 限制范围,效果更自然
✅ 一句话总结:
Top-k:取前 k 个概率最高词来选。Top-p:选出累积概率前 p 的词集合采样。二者都用于提高语言模型生成的“可控性”和“自然度”。
机器学习算法