Transformer是什么
杜瑞成 ·
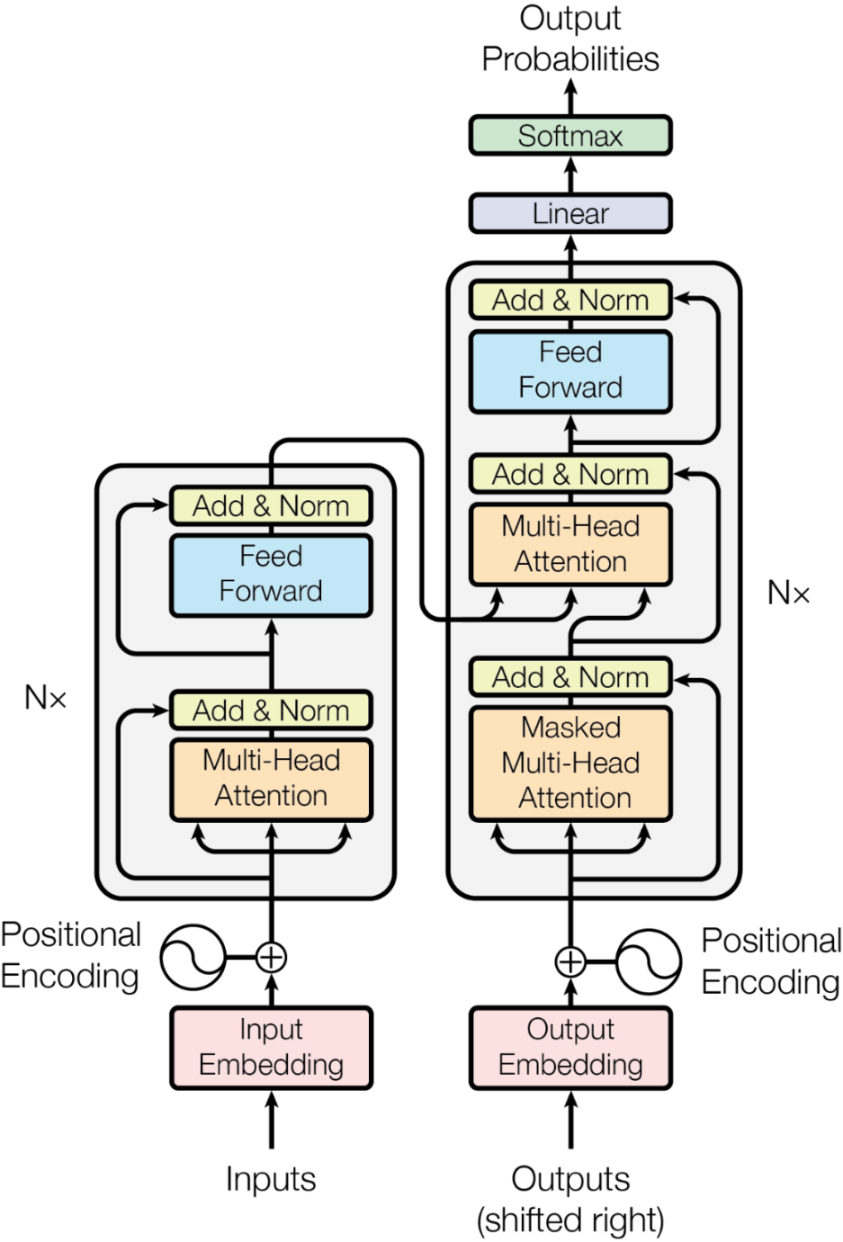
论文地址:http://nlp.seas.harvard.edu/annotated-transformer/
代码地址:https://github.com/harvardnlp/annotated-transformer
基本概念
RNN 的“根本问题”是什么?
-
不可并行(Sequential Bottleneck)
第 $t$ 步必须等 $t-1$ 步完成
-
长程依赖难建模(Long-Range Dependency)
信息从 $x_1 \rightarrow x_T$ 需要经过 T 次非线性变换(递归更新)
Transformer 使用 self-attention 替代递归,使序列中任意两个位置可以在同一层中直接交互,从而实现完全并行的矩阵计算。同时,self-attention 将长程依赖的传播路径从 $O(n)$ 缩短为 $O(1)$,显著缓解梯度消失问题。
Transformer 的整体结构是什么?
- Encoder–Decoder 架构
- Encoder:Self-Attention + FFN
- Decoder:Masked Self-Attention + Cross-Attention + FFN
位置编码(Positional Encoding)
为什么需要位置编码?
因为Transformer中多头注意力机制对输入 token 的顺序不敏感,仅通过语义关联计算权重。因此在模型最开始的输入部分加入 位置编码(Positional Encoding) 给每个 token 的特征向量添加位置信息,且位置相近的 token,编码向量的相似度更高。
什么是位置编码?
输入部分$X$的构成如下:
$X = \sqrt{d_{model}} \cdot E_{\text{token}} + E_{\text{position}}$
Embedding 乘以 $\sqrt{d_{model}}$,是为了让 token embedding 的数值尺度与后续 attention 中 $\frac{QK^\top}{\sqrt{d_k}}$ 的尺度保持一致,避免位置信息或注意力 logits 被“淹没”或“放大”。
$E_{\text{position}}$为位置编码,使模型能通过点积和线性变换显式感知相对位置差。
位置编码的分类
Sinusoidal / Learnable PE 都是:
- 绝对位置编码(Absolute Position Embedding)
- 正弦余弦位置编码(Sinusoidal Position Embedding)
- 可学习位置编码(Learned Position Embedding)
- 相对位置编码(Relative Position Embedding)
- 经典相对位置编码(Relative Position Embedding)
- 旋转位置编码(Rotary Position Embedding, RoPE)
正弦余弦位置编码(Sinusoidal PE)
Transformer原始论文使用的是Sinusoidal PE
对于序列中第 $pos$ 个位置($pos$ 从 $0$ 开始)、编码维度为 $i$ 的位置编码值,公式分为两种:
- 当 $i$ 为偶数时(维度索引从 0 开始): $PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right)$
- 当 $i$ 为奇数时: $PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right)$
其中,分子$pos$为绝对位置坐标;分子$10000^{2i/d_{\text{model}}}$控制该维度的$\omega_i$,即频率大小,当$i$大时,分母大($\omega_i$小),频率低,波长长。
三角函数“频率”在数学上的一般的形式是:
$\boxed{ y(x) = \sin(\omega x + \phi) }$
或$y(x) = \cos(\omega x + \phi)$
其中:
| 符号 | 含义 |
|---|---|
| $\omega$ | 角频率(angular frequency),越小周期越长 |
| $\phi$ | 相位(phase) |
Transformer 使用 $\text{sin}$/$\text{cos}$ 作为位置编码,是因为它们在不同维度上具有不同频率,从而在同一个位置向量中同时编码“局部顺序”和“整体位置”。
在位置编码公式中,维度索引 $i$ 决定三角函数的频率大小: 小 $i$ 对应高频函数,波长短,对位置变化非常敏感,能够区分相邻 token 的先后顺序; 大 $i$ 对应低频函数,波长长,对位置变化不敏感,但能反映 token 在整个序列中的大致位置范围。
因此,高频维度提供细粒度的局部顺序信息,低频维度提供粗粒度的全局位置信息。 多种频率叠加后,模型可以通过线性运算(attention 的点积)感知 token 之间的相对位置关系。
因为,对任意一个频率 ( $\omega$ ):
$\begin{aligned} \sin(\omega p_1)\sin(\omega p_2) + \cos(\omega p_1)\cos(\omega p_2) &= \cos(\omega(p_1 - p_2)) \end{aligned}$
通过点积运算(虽然经过一次线性投影),自然会将不同词向量的相同维度进行相乘,然后相加,最终点积结果自带不同位置的差异。
位置编码本身是固定的,不通过反向传播更新,它的作用是为输入嵌入提供一个稳定的、结构化的位置坐标系。
为什么PE位置编码是相加,而不是相减或者乘除?
乘法问题:
- (破坏语义)如果某个embedding的位置编码接近 0,会直接抹杀词向量的信息。
- (数值不稳定)embedding 或者 PE 很小或很大 → 相乘后会被放大或压缩 → 不稳定
除法问题:
- 当 PE 为0时,会引发除零错误,同样存在数值不稳定。
减法问题:
- 减法看起来不直观,且如果 $p$ 很大,会把 $x$ 减没了(数值稳定性不如加法)
可学习位置编码(Learnable PE)
初始化一个随机的位置编码矩阵(形状:$\text{max_len} \times d_{\text{model}}$,$\text{max_len}$ 是模型支持的最长序列)
$PE\in \mathbb{R}^{L\times d_{\text{model}}}$,其中第 $i$ 行(位置 $i$)的embedding为$pe_i\in\mathbb{R}^{d_\text{model}}$
将其作为模型可训练参数
与词嵌入相加后参与整个模型的反向传播,随任务迭代优化。
$X = \sqrt{d_{model}} \cdot E_{\text{token}} + PE$
相对位置编码
绝对位置编码(Learnable / Sinusoidal)的本质问题
- 给每个 token 一个 绝对编号
- 但Attention 实际更关心的是:
“这个词在我前面还是后面?”
“离我 3 个词远,还是 30 个词远?”
也就是让模型感知两个词之间的相对距离
ALiBi位置编码(Attention with Linear Biases, ALiBi)
(Press et al., 2022)从Attention入手(对于乘性注意力):
$\text{score}{ij} = \underbrace{Q_i^\top K_j}{\text{内容相关性}} + \underbrace{f(i - j)}_{\text{位置偏置(方向 + 距离)}}$
其中,$i$为query的位置,$j$为key的位置,$f(\cdot)$为相对位置偏置函数。ALiBi 对 $f(i-j)$ 的定义是简单的线性函数:
$f(i-j) = -m \cdot |i-j|$
相对 PE(Shaw et al.)
或者更一般的经典形式(Shaw et al., 2018):$\text{score}{ij} = Q_i^\top K_j+ Q_i^\top r{i-j}$
旋转位置编码(RoPE)
RoPE同样作用与Attention上,对于每个$Q_i$和$K_j$:
$Q_i' = R_{\theta_i} Q_i \quad K_j' = R_{\theta_j} K_j$,那么$\text{score}_{ij}=(Q_i')^\top K_j'$
这里,token $i$ 自己带了一个“方向”,token $j$ 自己也带了一个“方向”。注意力点积时,会自动计算它们的方向差。
推导:
$\quad(R_{\theta_i} Q_i)^\top (R_{\theta_j} K_j)$
$=Q_i^\top R_{\theta_i}^\top R_{\theta_j} K_j\quad\because (AB)^\top = B^\top A^\top$
$=Q_i^\top R_{-\theta_i} R_{\theta_j} K_j \quad \because R_\theta^\top = R_{-\theta}\quad$ 二维旋转矩阵转置 = 反方向旋转
$=Q_i^\top R_{\theta_j - \theta_i} K_j\quad \because R_a R_b = R_{a+b}\quad$
旋转矩阵的乘法=角度相加
旋转位置编码(RoPE)的具体步骤:
-
对第 $p$ 个 token、第 $i$ 对维度,旋转角度为:$\theta_{p,i} = \frac{p}{10000^{2i/d_{\text{model}}}}$
(这一步与Sinusoidal PE一致)
-
每两维一组做旋转
例如,对于一对维度 $(x_{2i}, x_{2i+1})$(第二个词的每个特征):
$\begin{pmatrix} x'{2i} \ x'{2i+1} \end{pmatrix} =\begin{pmatrix} \cos\theta_{p,i} & -\sin\theta_{p,i} \ \sin\theta_{p,i} & \cos\theta_{p,i} \end{pmatrix}\times \begin{pmatrix} x_{2i} \ x_{2i+1} \end{pmatrix}$
T5
$\text{Attn}(i,j) \frac{Q_i^\top K_j}{\sqrt{d_k}}+b_{h}(i-j)$,其中,${h}$$h$意力头,$b_h(\cdot)$为相对位置偏置。
| 方法 | 位置进入方式 | 本质 |
|---|---|---|
| T5 相对偏置 | 加到 score | 显式偏置 |
| ALiBi | 线性惩罚 | 固定距离先验 |
| RoPE | 改 Q/K 表示 | 几何相对编码 |
一句话:
T5 是“告诉注意力该不该看你”,RoPE 是“让注意力自然对齐你”。
注意力机制
Transformer的编码器中,使用的是多头自注意力,其中头数默认为8,自注意力体现在$Q=K=V=x$。解码器中使用的是掩码多头自注意力和源注意力(交叉注意力,$K=V≠Q$)。
注意力的分类
硬注意力和软注意力的核心区别在于注意力权重是「离散的、二值化的」还是「连续的、概率化的」。Transformer使用的是软注意力。
| 特性 | 软注意力(Soft Attention) | 硬注意力(Hard Attention) |
|---|---|---|
| 权重性质 | 连续的概率分布,$\sum \alpha_i = 1$ | 离散的二值分布,只有一个 $\alpha_i=1$,其余为0 |
| 计算方式 | 对所有输入计算注意力分数,加权求和 | 只选择一个(或少数)输入,忽略其他所有输入 |
| 可微性 | 完全可微,支持反向传播训练 | 不可微,需用强化学习(如 REINFORCE)训练 |
| 代表模型 | Transformer、Bahdanau/Luong Attention | 早期图像注意力模型、部分稀疏注意力模型 |
注意力计算方式介绍
两种最常用的注意力函数是加性注意力和点积(乘性)注意力(不包含缩放因子)。
加性注意力:$\text{score}(q, k_i)=\mathbf{v}^\top\tanh(\mathbf{W}_q q + \mathbf{W}_k k_i)$,结构公式结构类似RNN,其实就是用一个小的MLP(FCN/FFN)来学习是否相似。
乘性注意力:$\text{score}(q, k_i) = q^\top k_i$,通过向量内积衡量二者的相似度 —— 内积越大,说明当前目标词与源词的关联越强,注意力权重越高。
Transformer中用的是乘性注意力:
$Attention(Q,K,V)=softmax(\frac{QK^\top}{\sqrt{d_k}})V$
为什么Transformer中给乘性注意力添加了缩放因子$\frac{1}{\sqrt{d_k}}$?
点积注意力的标准公式:$\text{score}(q, k) = q \cdot k = \sum_{i=1}^{d_k} q_i k_i$
其中$d_k$为k的维度,向量点积就是两个向量逐元素相乘相加。当 $d_k$取值较小时,两种注意力机制的表现相近,但当$d_k$较大时,加性注意力的效果要优于未做缩放的点积注意力。因为:当$d_k$较大时,点积的数值幅度会急剧增大,将 softmax 函数推向梯度极其微小的区域。为抵消这一影响,我们将点积结果乘以缩放系数$\frac{1}{\sqrt{d_k}}$。
多头注意力机制(Multi-Head Attention)
多头注意力是指将同一个输入投影到多个不同的子空间中,并行地计算多组注意力,再将结果拼接并线性变换,从而捕捉不同类型的关系。
头数越多越好吗?
每个头表示一个不表示空间,每个同头学习不同的特征(不同依赖关系/语法关系/位置关系等等)
但是,头数增加 ≠ 多样性一定增加:
- 每个头的维度为$d_k = \frac{d_{\text{model}}}{H}$。如果$d_{\text{model}} = 512$ :当 $H = 8$时,$d_k = 64$(正常维度);当$H = 32$时,$d_k = 16$,特征的表达能力下降。
- 每个头中都又投影、矩阵乘法、Softmax等运算,头数的增加意味着内存和时间的开销增大。
- 头数增加就可能存在多个头学习到的特征高度相似,所以就有很多论文在研究头剪枝
掩码注意力(Masked Attention)是怎么实现的?
掩码多头注意力(Masked Multi-Head Attention)是普通多头注意力的带约束版本,核心是在注意力分数计算后、Softmax 归一化前,给模型不该关注的位置的分数加一个极小的负数(如 - 1e9),让这些位置经过 $\text{Softmax}$ 后注意力权重趋近于 0,强制模型 “忽略 / 看不到” 这些位置。
掩码的类型有两种:
第一类掩码:填充掩码(Padding Mask), 编码器 、解码器都要用。
- 处理文本时,我们会把一个批次的句子拼成相同长度的张量:短句子末尾补 0(Padding),长句子截断。
- 填充掩码会给序列中位置加
- 1e9,让模型计算注意力时,完全忽略这些 0-token。
第二类掩码:未来掩码(Look-Ahead Mask)/ 因果掩码(causal mask),仅解码器的自注意力使用。
- 因为,解码器自注意力的 Q/K/V全部来自解码器自身已生成的 token,它的核心任务是保证自回归生成的逻辑(逐个生成 token,生成第 t 个时,只能基于前 1~t 个 token)
- 而编码器需要全局语义关联,需要让每个 token 都能关注到整个序列的所有位置,并且编码器的输入序列是完全已知的,(比如翻译任务中,源语言 “我喜欢中国” 是完整输入,所有 token 都已存在,没有 “还没生成的词”)
- 解码器的交叉注意力中,Q 来自解码器的掩码自注意力输出,是已知的输出,交叉注意力的作用是 “让这个 Q 去编码器的全局特征中找匹配”,因此不需要再次掩码。
为什么需要交叉注意力(Cross-Attention)?
注意力机制的本质是通过 Q(查询)匹配 K(键)计算注意力权重,再用权重对 V(值)加权求和,交叉注意力与自注意力的核心区别就在Q、K、V 的来源。
Transformer中,编码器主“理解”,解码器主“生成”,交叉注意力的目的是实现“理解” 到 “生成” 的语义映射(将Q对齐编码器的源序列)。Q(查询)来自解码器已生成的目标序列特征;K(键)、V(值)全部来自编码器的最终输出(即源序列的全局语义特征,编码器已完成源序列的特征提取和全局融合)。
Flash Attention
残差连接+层归一化
Transformer在每个子层外都采用了残差连接,随后进行层归一化。
$\boxed{\text{LayerNorm(x+\text{Sublayer(x))}}}$
残差连接(Residual Connection)
其中,残差结构:$y = x + \text{Sublayer}(x)$
残差连接的核心作用是缓解梯度消失、稳定深层网络训练,并避免有用信息在多层非线性变换中被破坏。
为什么这种“加法”形式这么关键?
反向传播时,$\frac{\partial y}{\partial x} =\frac{\partial (x + F(x))}{\partial x}=I + \frac{\partial F(x)}{\partial x}$,即使$\frac{\partial F}{\partial x} \approx 0$,梯度至少还有 $I$。
如果没有残差一旦子层学得不好,信息直接损毁。
通过残差连接,模型可以学习$\text{Sublayer}(x)\approx y-x$,也就是“增量”(residual),这是深度网络能堆到几十上百层的关键原因。
残差连接本身解决了什么问题?
残差连接(Residual Connection)本质是:$y=x+F(x)$
它解决的是深层网络难训练的问题:
防止子层$F(x)$ 学不好时,整个网络“退化”;让梯度可以直接沿着 identity path(恒等映射) 反向传播。
残差连接之后会引入一个新问题:分布失控(distribution drift)
$x$和$F(x)$的均值$\mu$不同、标准差$\sigma$不同相加后标准差可能变大、特征尺度在层与层之间不断漂移。
尺度是指数据的分布范围,例如$[-0.1,0.1]$属于小尺度,$[-10,10]$属于大尺度。 我们希望的理想状态是每层的均值$\mu$和方差$\sigma^2$不发生变化(不漂移)。 但如果$\sigma_x^2\approx1$且$\sigma_{F(x)}^2\approx1$,那么残差连接后$y=x+F(x)$的方差$\sigma_{y}^2\approx2$,多层堆叠方差会越来越大。
因此,需要对残差连接后的特征进行标准化,重新拉回一个稳定、可控的分布空间。
层归一化(Layer Normalization)
为了解决残差连接导致的特征尺度漂移问题,Transformer引入层归一化。
$\text{LayerNorm}(x)=\gamma\frac{x-\mu}{\sqrt{\sigma^2+\epsilon}}+\beta$
其中,$\mu$为均值,$\sigma$为方差(为了防止方差≈0加了一个极小的常数)
而$\gamma$是可学习的缩放参数,$\beta$是可学习的平移参数。
为什么要有$\gamma$和$\beta$?
如果没有$\gamma$和$\beta$,LayerNorm的公式是$\frac{x-\mu}{\sigma}$,如果LayerNorm对于当前任务没有任何帮助,那么该公式会强制对$x$进行归一化。
有了$\gamma$和$\beta$后,公式$\gamma\frac{x-\mu}{\sigma}+\beta$中,令$\gamma=\sigma$,$\beta=\mu$,那么 LayerNorm 可以退化成恒等映射,即输入=输出。因此$\gamma$和$\beta$一定需要,且一定是可学习参数。
LayerNorm 和 BatchNorm 的区别?
BatchNorm (BN),对同一维特征,在 batch 维度 上归一化:
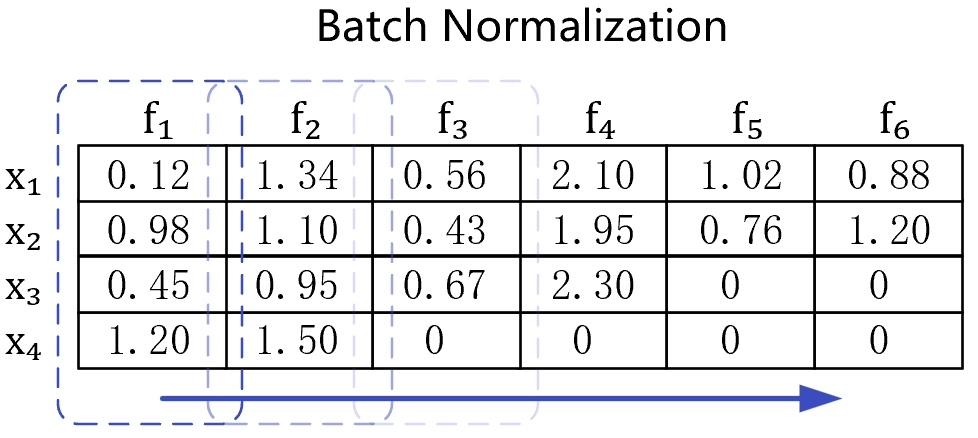
$\mu = \frac{1}{B}\sum_{b=1}^B x_{b,i},\quad \sigma^2 = \frac{1}{B}\sum_{b=1}^B (x_{b,i}-\mu)^2$
LayerNorm (LN),对单个样本,在 特征维度 上归一化:
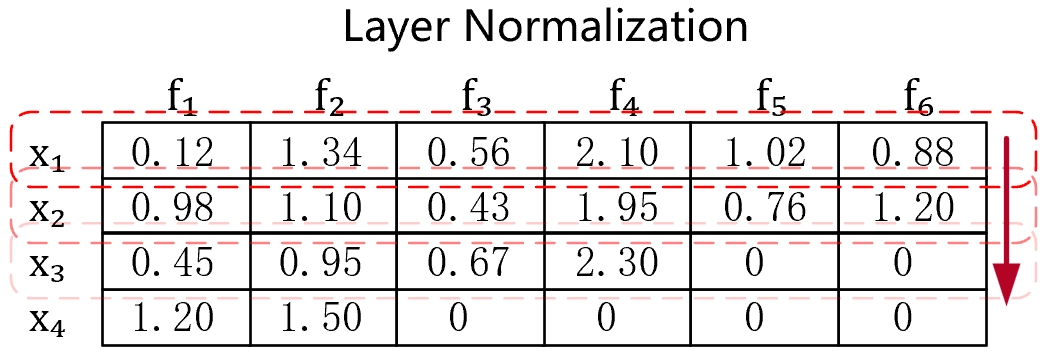
$\mu = \frac{1}{d}\sum_{i=1}^d x_{i},\quad \sigma^2 = \frac{1}{d}\sum_{i=1}^d (x_{i}-\mu)^2$
为什么用 LayerNorm而不是BatchNorm?
BatchNorm是跨样本、按特征维度计算均值和方差
而NLP任务中:一批的句子长短不一;batch_size通常很小;不同样本之间可能语义差异大。
一个极端的例子:
# 原始数据:
tensor([[100., 200., 300., 400.,   0.],
        [  1.,   2.,   3.,   0.,   0.]])
--------------------------------------------------
# BN 归一化结果 (变成了完全相反的分布,且无法保留 token 之间的相对关系):
tensor([[ 1.0000,  1.0000,  1.0000,  1.0000,  0.0000],
        [-1.0000, -1.0000, -1.0000, -1.0000,  0.0000]],
       grad_fn=<NativeBatchNormBackward0>)
--------------------------------------------------
# LN 归一化结果 (语义结构被完整保留):
tensor([[-0.7071,  0.0000,  0.7071,  1.4142, -1.4142],
        [-0.1715,  0.6860,  1.5435, -1.0290, -1.0290]],
       grad_fn=<NativeLayerNormBackward0>)
LayerNorm 不依赖 batch 统计量,适合变长序列、小 batch 以及自回归推理场景。
前馈网络(Feed-Forward Networkk)
Transformer 的 FFN 就是 MLP,因为是纯前馈型神经网络(数据单向流动,无循环 / 递归),因此将其中的 MLP 称为 FFN。
FC(全连接层)、MLP(多层感知机)、DNN(深度神经网络)、FFN(前馈网络)之间的关系:
$\underbrace{FC(基础积木)}{线性层} \xrightarrow{+激活+堆叠(≥2层)} \underbrace{MLP(基础网络)}{经典全连接结构} \xrightarrow{堆叠(≥3层)+ 归一化/残差} \underbrace{DNN(深层网络)}_{深层MLP}$
$MLP \xrightarrow{适配Transformer/序列任务} \underbrace{FFN(场景化变体)}_{Transformer中的MLP}$
为什么Transformer需要FFN?
FFN的作用是对注意力机制输出的序列特征做精细化的非线性变换与特征增强,让模型具备更强的特征表达能力。
如果只有 Attention(线性加权):$Attn(X)=AX$,那么这就是一个线性模型,表达能力严重受限。
FFN可以通过“特征与权重矩阵的加权求和”来重组特征,然后通过激活函数引入非线性,再把高维非线性结果映射回语义空间。只要中间有一次“非线性”,整体就不再是线性的。
最简单的前馈网络形式(MLP):$y = W_2(\sigma(W_1x+b_1))+b_2$,线性变换+非线性激活+线性变换。
为什么要设定FFN的中间维度更大?
高维度 → 可以表示更多复杂组合模式
输出层
!TODO
Linear用于将特征转换为词表大小。
- 可学习位置编码
- ALiBi、RoPE、T5 相对位置编码
FlashAttention